1. Qual problema o artigo aborda?
A maioria dos estudos sobre modelos de linguagem de grande porte (LLMs) na medicina perguntou sobre a precisão. O modelo consegue nomear o diagnóstico, passar no exame, superar o médico? Mas quando uma sugestão de IA é colocada em prática em uma clínica, as primeiras coisas que mudam são pedidos de exames, encaminhamentos e prescrições. Cada um deles tem um custo.
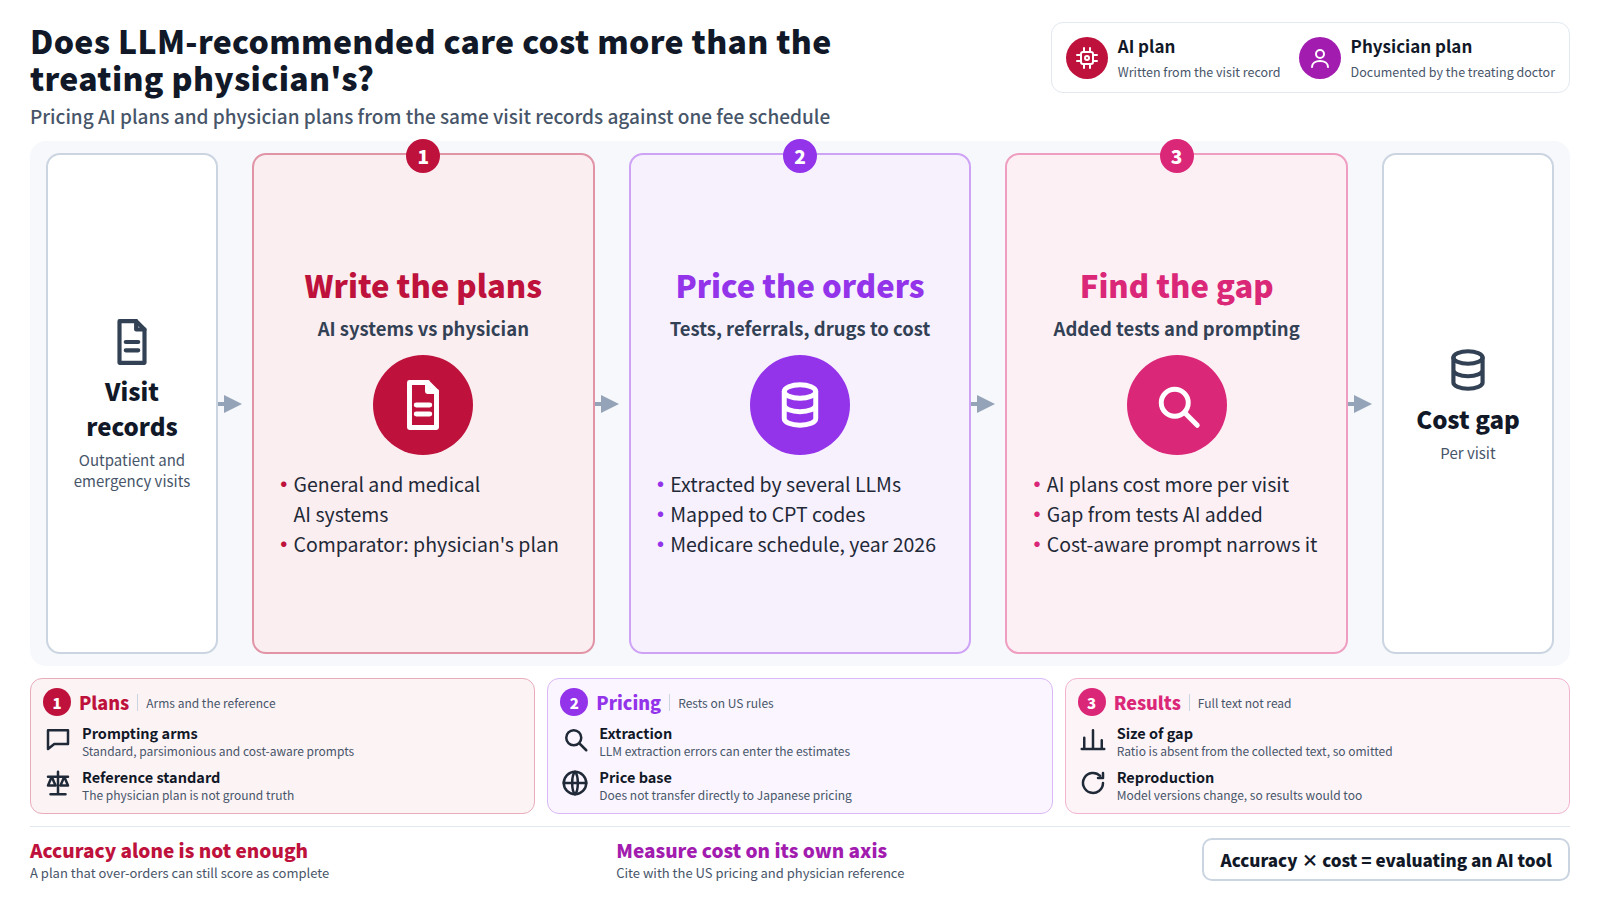
Este artigo original, publicado na NEJM AI após revisão por pares, desloca a questão da precisão para o custo. Diante do mesmo registro de atendimento, o plano de cuidados escrito por um LLM custa um valor diferente do plano do médico que realmente atendeu o paciente? Se sim, o que gera a diferença, e a maneira como o modelo é instruído altera isso[1]?
Uma IA com pontuação alta de acurácia ainda pode aumentar os gastos e a carga sobre os pacientes se tender a empilhar exames "por via das dúvidas." Corte os custos demais e coisas passam despercebidas. Acurácia e custo precisam ser medidos em eixos separados; esse é o ponto de partida do artigo.
2. O que se propõe?
O núcleo do método é precificar o plano da IA e o plano do médico em relação à mesma tabela de honorários. De acordo com a descrição pública dos autores sobre seus dados e o código de análise, as informações apresentadas foram extraídas de registros de consultas ambulatoriais e de atendimentos de emergência, e um conjunto de sistemas de IA, tanto LLMs de uso geral quanto sistemas médicos especializados, foi solicitado a redigir uma avaliação e um plano. O comparador é o plano documentado pelo médico assistente[3][4].
Testes, encaminhamentos e medicamentos de cada plano foram extraídos por vários LLMs independentes e mapeados para códigos de procedimentos dos EUA (CPT). Os pedidos foram então precificados com o Medicare Physician Fee Schedule para o ano-calendário de 2026, e os medicamentos com uma pesquisa nacional de preços de medicamentos dos EUA. Além de um prompt padrão, dois braços de prompting foram executados: um pedindo um plano parcimonioso e outro pedindo ao modelo que fosse consciente de custos[4].
Portanto, o estudo não dá uma nova capacidade à IA. Ele remediu o resultado já existente da IA com uma régua da economia da saúde.
3. O que isso mostrou, dentro do que podia ser verificado?
Uma ressalva primeiro. No registro bibliográfico coletado para este site, o campo de resumo continha apenas a linha "NEJM AI, Ahead of Print." No momento da escrita, a página do artigo do NEJM AI não pôde ser acessada, e o texto completo não foi lido. O que se segue baseia-se no resumo que o grupo dos autores publicou em sua própria página de publicações[2].
De acordo com esse resumo, os cuidados recomendados pelos sistemas de IA custaram mais por consulta do que os cuidados recomendados pelos médicos assistentes. A maior parte da diferença veio de exames que a IA acrescentou em consultas nas quais o médico não havia pedido nenhum. Prompts sensíveis a custo reduziram a diferença, mas nunca a fecharam, escrevem os autores.
O resumo também dá uma razão para o tamanho da lacuna. Este artigo não publica números que estejam ausentes do texto primário que coletou, então a razão é omitida aqui. Leitores que quiserem a magnitude devem recorrer diretamente ao artigo do NEJM AI e ao resumo dos autores.
O repositório público também lista análises de avaliações de adequação feitas por médicos, concordância diagnóstica entre IA e médico e confiabilidade teste-reteste[4]. A forma como esses resultados são relatados no artigo não pôde ser confirmada dentro do escopo deste artigo.
4. Um exemplo prático
Considere uma equipe de assuntos médicos de uma fabricante de medicamentos avaliando uma ferramenta de suporte por IA para profissionais de saúde.
Uma reunião interna de revisão
Desenvolvedor: "Nos casos de avaliação, a concordância diagnóstica com os médicos assistentes foi praticamente a mesma. Os planos não deixam nada passar."
Líder de economia da saúde: "Você contou os exames nesses planos? Nas consultas em que o médico optou por espera vigilante, a IA está acrescentando exames de sangue e de imagem?"
Desenvolvedor: "Realmente parece haver muitos exames por precaução. Mas assim se erra pelo lado seguro."
Líder de economia da saúde: "Se isso é seguro depende de se esses exames mudaram a conduta. Eles acrescentam custo e ônus ao paciente, então, a menos que meçamos isso separadamente da acurácia, não avaliamos a ferramenta."
O artigo traz a visão do segundo palestrante. Em uma comparação de precisão, um plano que pede demais pode pontuar bem como "completo." Alinhe os planos por custo e a distorção fica visível.
5. O que não é novo, e onde estão os limites?
Estudos comparando LLMs com médicos são abundantes: precisão diagnóstica, questões de exame, leitura de imagens. O quadro de comparação em si não é novo. O que é novo aqui é a régua de avaliação. Os blocos de construção — extração de prontuários, mapeamento de códigos e precificação segundo uma tabela de tarifas — são padrão em pesquisa de economia da saúde. Vários limites podem ser identificados no material disponível.
- O plano do médico não é a verdade absoluta. A referência é o que o médico assistente fez, e um médico que não solicitou nenhum exame não estava necessariamente certo. Alguns exames acrescentados pela IA podem ter coberto algo que o médico deixou passar. As diferenças de custo, por si só, não dizem qual plano foi melhor para o paciente.
- A precificação depende do sistema dos EUA. Como são usados a tabela de honorários do Medicare e dados de preços de medicamentos dos EUA, os resultados não se transferem diretamente para o reembolso ou os preços de medicamentos no Japão. A direção da diferença pode ser informativa; sua magnitude depende do sistema.
- O registro da visita é texto. A IA leu uma nota e escreveu um plano; o médico encontrou o paciente e ponderou preferências e seguro de saúde. É difícil dizer que ambos os lados tinham as mesmas informações. O repositório inclui um snapshot de um corpus público de transcrições médicas, mas exatamente de onde vieram os casos não pôde ser confirmado aqui.
- A reprodução é limitada. O próprio repositório adverte que as versões dos modelos e a disponibilidade das APIs mudam, então executar as consultas novamente não daria os mesmos resultados. As saídas salvas refletem o comportamento dos modelos observado na primavera de 2026[4].
- A extração também é feita por LLMs. Extrair exames e medicamentos dos planos depende de LLMs, de modo que erros de extração podem contaminar as estimativas de custo. Usar vários modelos serve para conter isso, mas o nível de erro não pôde ser confirmado aqui.
6. Como o artigo foi coberto?
A etapa de seleção deste site escolheu o artigo como um que passou por revisão por pares e foi coberto por vários veículos independentes. Os veículos listados foram Nature, Science, Frontiers, Neurology Today e medRxiv, cinco no total. Alinhe as manchetes, porém, e nenhuma delas trata deste artigo.
- Nature: "Modelos de linguagem multimodais de grande porte enfrentam o desafio de imagens do NEJM" (precisão em perguntas de imagens)
- Ciência: "Desempenho de um modelo de linguagem de grande porte nas tarefas de raciocínio de um médico" (tarefas de raciocínio médico)
- Neurology Today: "Modelo de linguagem de grande porte supera médicos na precisão da codificação diagnóstica" (precisão de codificação)
- medRxiv: "Multimodal Large Language Model Passes Specialty Board Examination…" (notas do exame de especialidade)
- Frontiers: "Avaliação cega em duas fases de grandes modelos de linguagem em cirurgia cardíaca complexa…" (desempenho em tarefas de cirurgia cardíaca)
Todos os cinco são estudos separados cujos títulos por acaso associam LLMs a médicos. A etapa de seleção os relacionou por palavras em comum; eles não são evidência de que este artigo foi noticiado. Para este artigo, o motivo de seleção declarado de cobertura independente não se sustenta.
A discrepância ainda é informativa. Cada manchete capturada se apoia na pergunta "a IA é mais precisa do que os médicos?" Este artigo fica fora dessa pergunta: precisão igual não significa custo igual. Que um critério de custo tenha chegado a um periódico revisado por pares enquanto a atenção da imprensa está fixada na precisão é algo que vale registrar. Nem a publicação em um periódico revisado por pares nem a seleção por este site garantem que os resultados estejam corretos, tenham valor clínico ou sejam inéditos.
7. Onde isso se conecta ao trabalho farmacêutico e regulatório?
Primeiro, critérios de avaliação para ferramentas de apoio com IA. Se um sistema apresenta opções de cuidado a profissionais de saúde, a avaliação deve cobrir não apenas a precisão, mas também o quanto as sugestões aumentam exames, encaminhamentos e prescrições. O desenho do estudo oferece um modelo para fazer isso.
Em segundo lugar, os prompts movem o resultado. No resumo dos autores, instruções conscientes de custo reduziram a diferença. O prompt de sistema é, portanto, parte da especificação do produto e deve estar sob controle de mudanças e guarda de registros. Se uma única instrução pode alterar o padrão de recomendações, uma avaliação não pode ser reproduzida, a menos que o prompt utilizado seja registrado.
Terceiro, avaliação econômica em saúde. À medida que a IA participa de mais recomendações, a própria forma como medicamentos e testes são utilizados pode mudar. Trabalhos de custo-efetividade e estudos de utilização pós-comercialização podem precisar de uma maneira de capturar o quanto as recomendações de IA estiveram envolvidas.
Nada disso significa que os resultados possam ser aplicados ao sistema japonês tal como ele está. Ao citar o estudo, vale a pena destacar que a precificação se baseia nas regras dos EUA e que o padrão de referência é o julgamento do médico assistente.