1. Ein falscher Schritt prägt alles, was danach kommt
Ein Terminal-Agent erzeugt einen Shell-Befehl, führt ihn aus, liest die Ausgabe und entscheidet über den nächsten Befehl. Da die Modellgenerierung stochastisch ist, liefert dieselbe Situation jedes Mal leicht unterschiedliche Befehle.
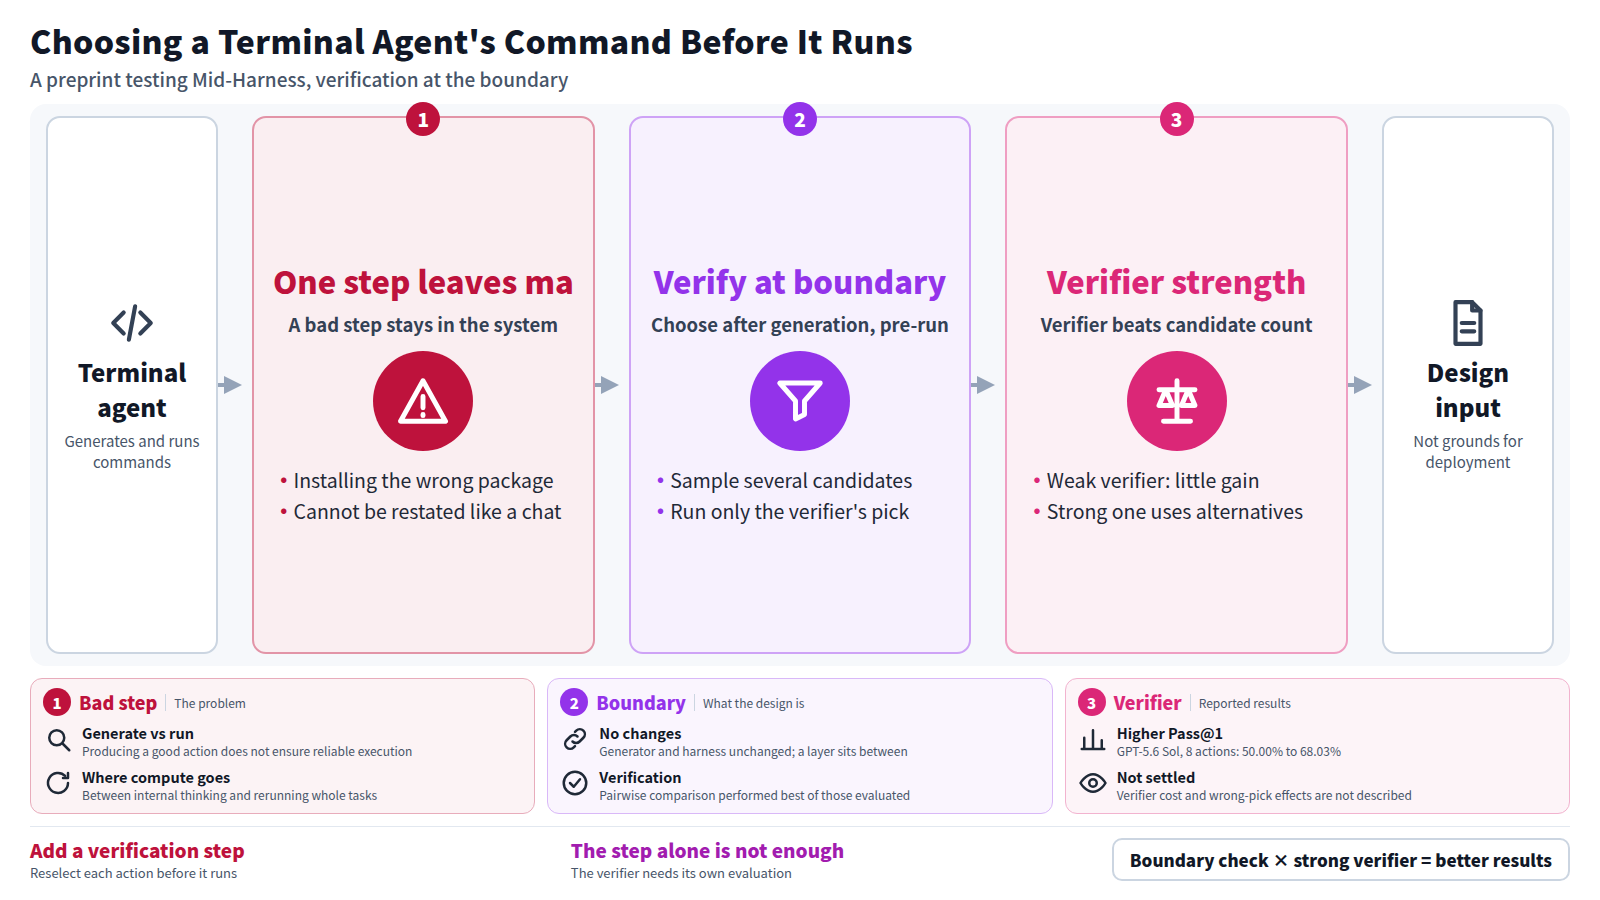
Die Autoren gehen von der Beobachtung aus, dass die Fähigkeit, eine nützliche Aktion zu generieren, gewährleistet nicht, dass die Aktion zuverlässig ausgeführt wird. Ihr Beispiel ist die Installation des falschen Pakets. Ein schlechter Befehl schreibt die Umgebung selbst um, sodass späterer Fortschritt behindert wird, selbst wenn das Modell eine bessere Alternative hätte liefern können. In einem Chat lässt sich eine schlechte Antwort in der nächsten Nachricht korrigieren; in einem Terminal hinterlässt die Operation Spuren in der Umgebung.[1]
Das führt sie zu der Frage, wo Rechenleistung zur Testzeit eingesetzt werden sollte. Die üblichen Optionen sind, das Modell intern länger nachdenken zu lassen, oder die gesamte Aufgabe mehrfach neu durchlaufen zu lassen und das beste Ergebnis zu behalten. Dieses Papier untersucht eine dritte Option dazwischen: erneute Auswahl auf der Ebene jeder einzelnen Aktion. Die primäre Quelle ist ein auf arXiv eingestellter Preprint und hat noch kein Peer-Review durchlaufen.
2. Die Kernidee: an der Grenze verifizieren, dann ausführen
Der Kern von Mid-Harness passt in einen Satz: zwischen dem Moment, in dem das Modell eine Aktion generiert, und dem Moment, in dem der Harness sie ausführt, mehrere Kandidatenaktionen sampeln und nur die eine weiterleiten, die ein Verifizierer auswählt.
Weder das Modell, das Aktionen generiert (der Generator), noch das System, das Befehle ausführt (das Harness), wird verändert. Mid-Harness ist eine Schicht, die zwischen beide eingefügt wird, sodass es sich ausprobieren lässt, ohne die Struktur eines bestehenden Agenten zu verändern.
Mehrere Verifikationsmechanismen werden verglichen. Die Zusammenfassung stellt die Verwendung eines stärkeren externen Modells als Verifizierer der Verwendung des Generatormodells selbst als Verifizierer gegenüber. Im letzteren Fall schneidet die paarweise Verifikation, die Kandidaten immer zwei auf einmal vergleicht, unter den evaluierten Mechanismen am besten ab. Darüber hinaus verbessert das Destillieren der Antworten des stärkeren Verifizierers in dasselbe kleine Modell die Ergebnisse zusätzlich, während der Aktionsgenerator unverändert bleibt.
3. Was die Zusammenfassung berichtet
Mit TMAX-9B als Generator bringt das Sampling weiterer Aktionen wenig Nutzen, wenn die Verifikation schwach ist. Mit einem leistungsfähigen Verifizierer kann der Agent dagegen nützliche Alternativen nutzen, die derselbe Generator bereits erzeugt hatte, so die Autoren.
Eine konkrete Zahl wird genannt. Auf TerminalBench-Lite erhöht sich Pass@1, wenn GPT-5.6 Sol als Verifizierer mit 8 gesampelten Aktionen verwendet wird, von 50.00% für den Basis-Agenten auf 68.03%. Pass@1 ist der Anteil der Aufgaben, die in einem einzigen Versuch gelöst werden.
Eine zweite Behauptung betrifft die Kosten. Mit TMAX-9B erreicht die Kombination von Action Scaling mit Trajectory Scaling einen höheren Erfolg bei geringeren geschätzten Token-Kosten als das alleinige Erzeugen weiterer Trajektorien. Außerdem heißt es, Mid-Harness verbessere die Ergebnisse auch über weitere Modelle, Benchmarks und Harnesses hinweg, doch das Abstract nennt sie nicht und gibt keine Zahlen an.
4. Ein durchgerechnetes Beispiel: Einrichten einer Analyseumgebung
Betrachten wir einen Agenten, der eine frische Umgebung für statistische Analysen einrichten, die erforderlichen Bibliotheken installieren und ein bestehendes Analyse-Skript zum Laufen bringen soll.
Basis-Agent
Agent: Installation der erforderlichen Bibliothek. (Es erzeugt einen Befehl für ein anderes Paket mit einem ähnlichen Namen und führt ihn sofort aus.)
Agent: Das Skript schlägt fehl. Die Abhängigkeiten werden korrigiert. (Das von ihm installierte Paket hat die Version einer anderen Bibliothek verändert, und jede Behebung beschädigt etwas anderes.)
Mit Mid-Harness
Agent: Generiere mehrere Kandidaten für Installationsbefehle.
Verifizierer: Ein Kandidat verweist auf ein ähnlich benanntes, aber anderes Paket. Weiterleitung des Kandidaten, der die beabsichtigte Bibliothek nennt.
Agent: Ausgewählten Befehl ausgeführt. Weiter mit der Ausführung des Skripts.
Beachten Sie, dass sich die Fähigkeit des Generators nicht geändert hat. Der richtige Befehl könnte auch unter den Kandidaten des Basis-Agenten auftauchen. Der Unterschied ist ob die Entscheidung, welcher Kandidat die Umgebung berührt, vor der Ausführung getroffen wird. Und, wie die Ergebnisse des Abstracts zeigen, hilft es nicht, mehr Kandidaten zu haben, wenn die Entscheidung schlecht getroffen wird.
5. Was nicht neu ist, und was das Abstract nicht klärt
Viele Kandidaten zu erzeugen und einen Verifier wählen zu lassen, ist keine neue Idee. Für mathematische Textaufgaben wurde bereits früher gezeigt, dass das Erzeugen vieler Lösungen durch Sampling und die Auswahl mit einem trainierten Verifier die Genauigkeit verbessern.[4] Das Grundmuster von Agenten, die Schlussfolgern und Handeln miteinander verzahnen, wurde durch Arbeiten wie ReAct etabliert.[5] The contribution here can be read as moving that selection from the level of whole tasks to die Ebene einer einzelnen Aktion, es an der Grenze zwischen Modell und Harness zu platzieren und zu untersuchen, was es funktionieren lässt.
Es gibt Grenzen. Zunächst beschreibt das Abstract nicht die Anzahl oder Zusammensetzung der Aufgaben in TerminalBench-Lite. Der Name ähnelt Terminal-Bench, einer Evaluationssuite für Terminal-Aufgaben,[3] aber der Zusammenhang lässt sich aus dem Abstract nicht bestätigen. Zweitens stammt der größte Gewinn daraus, ein starkes externes Modell als Verifier einzusetzen, und das Abstract macht nicht deutlich, wie viel der eigenen Kosten des Verifiers in den geschätzten Token-Kostenvergleich eingerechnet ist. Drittens wird nichts dazu gesagt, was passiert, wenn der Verifier einen falschen Kandidaten auswählt, etwa wie oft eine nicht umkehrbare Operation durchrutscht. Viertens war zum Zeitpunkt der Erfassung kein Code-Repository registriert.
Auf der Paper-Sharing-Seite hat das Papier 111 Upvotes und 5 Kommentare sowie 0 GitHub-Sterne.[2] Upvotes zeigen, wie weit verbreitet sie gelesen wurde, nicht, ob ihre Aussagen stimmen. Eine unabhängige Reproduktion wurde nicht gefunden.
6. Warum dies Aufmerksamkeit erhält, als Paper ohne Cluster
In diesem Sammellauf war die Clustergröße des Artikels 1, und es wurde nur eine Signalfamilie erhoben, nämlich Leserstimmen. Mit anderen Worten: Dies ist kein Fall, in dem mehrere unabhängige Arbeiten dieselbe Frage gleichzeitig aufgreifen; es ist ein einzelnes Paper, das Stimmen auf sich zog. Dies ist als eine Auswahl zu lesen, die unter dieser Bedingung getroffen wurde.
Dennoch spiegeln seine Schlüsselwörter (actions, harness, scaling, terminal) eine aktuelle Richtung wider. Diese Website hat kürzlich eine Reihe von Preprints zur Gestaltung und Selbstverbesserung des Harnesses behandelt, der einen Agenten umschließt. Wo frühere Arbeiten zwei Stellen boten, an denen Inferenz-Compute eingesetzt werden kann – im Modell selbst oder über wiederholte vollständige Versuche hinweg –, fügt dieses Paper eine dritte hinzu: die Grenze zum Harness.
Die beiden anderen am selben Tag ausgewählten Arbeiten befassen sich ebenfalls damit, worauf sich ein Agent verlässt, wenn er mitten in einer langen Aufgabe seinen nächsten Schritt wählt. Es sind jedoch eigenständige Arbeiten, die zur gleichen Zeit erschienen sind, und kein Cluster, der sich gegenseitig zitiert.
7. Wo dies an pharmazeutische und regulatorische Arbeit anknüpft
Der erste Bezug ist die Idee, vor dem Handeln zu prüfen. Im pharmazeutischen Betrieb ist es Standardpraxis, eine Änderung vor ihrer Anwendung auf ein System gegen ein freigegebenes Verfahren zu bestätigen. Mid-Harness schaltet etwas Ähnliches vor jede Aktion des Agenten. Es ersetzt keine menschliche Prüfung, ist aber ein nützlicher Input bei der Entscheidung, für Agenten, die in Geschäftsumgebungen eingesetzt werden, vor welchen Vorgängen ein Verifizierungsschritt sitzen sollte.
Das zweite ist die Aufzeichnung des Verifizierers. Wenn das System festhält, welche Kandidaten erzeugt wurden, welcher ausgewählt wurde und warum die anderen abgelehnt wurden, lässt sich der Verlauf der Vorgänge später nachvollziehen. Das Abstract beschreibt nicht, was protokolliert wird, daher müssten Nutzer das selbst aufbauen.
Der dritte Punkt ist die Abhängigkeit von der Qualität des Verifiers. In dieser Arbeit brachte das Hinzufügen von Kandidaten unter einem schwachen Verifier wenig Nutzen. Ein Verifikationsschritt ist für sich genommen kein Beleg für Sicherheit; der Verifier benötigt selbst eine Evaluation. Da es sich um ein Preprint handelt, sollte das Ergebnis eher als Input für die Gestaltung behandelt werden denn als Grundlage, Agents in Arbeiten einzusetzen, die irreversible Operationen umfassen.